“파일이 4 KB니까 요청도 4 KB”라고 계산하면 Base64 포장이나 문자열 인코딩 비용을 놓칩니다. 비트와 바이트를 배우는 목적은 크기 단위를 외우는 데서 끝나지 않습니다. 저장된 원본, 네트워크에 보낸 표현, 디코딩 후 메모리에 남은 데이터가 각각 몇 바이트인지 판단할 수 있어야 합니다.
2026년 10월 8일 Node.js 24.19.0에서 4,096바이트 데이터를 만든 뒤 바이너리 응답과 Base64 JSON 응답을 127.0.0.1 HTTP 서버로 직접 요청했습니다. 수신 길이, 헤더 길이, 디코딩 후 SHA-256, 문자열 길이, 메모리 공유를 포함한 18개 조건이 통과했습니다. 여기서는 바이트 비용을 다루며 정수 필드의 signed·엔디안 해석은 별도 글로 연결합니다.
1바이트는 8비트지만 KB와 KiB는 다르다
이 글에서 B는 바이트, bit는 비트입니다. 1 KiB는 1,024 B, 1 MiB는 1,048,576 B로 계산합니다. 십진 KB는 1,000 B입니다. API의 업로드 제한에 “5 MB”라고만 적혀 있으면 실제 제한이 5,000,000인지 5×1,048,576인지 서버 설정에서 확인해야 합니다.
네트워크 속도에서 Mbps는 초당 백만 비트이고 파일 크기는 보통 바이트로 표시합니다. 이상적인 시간은 바이트 수 × 8 ÷ 초당 비트 수로 계산하지만, 실제 속도에는 연결·프로토콜·압축·서버 처리 비용이 붙습니다. 이번 실험은 로컬 본문 길이만 측정했고 인터넷 전송 시간은 측정하지 않았습니다.
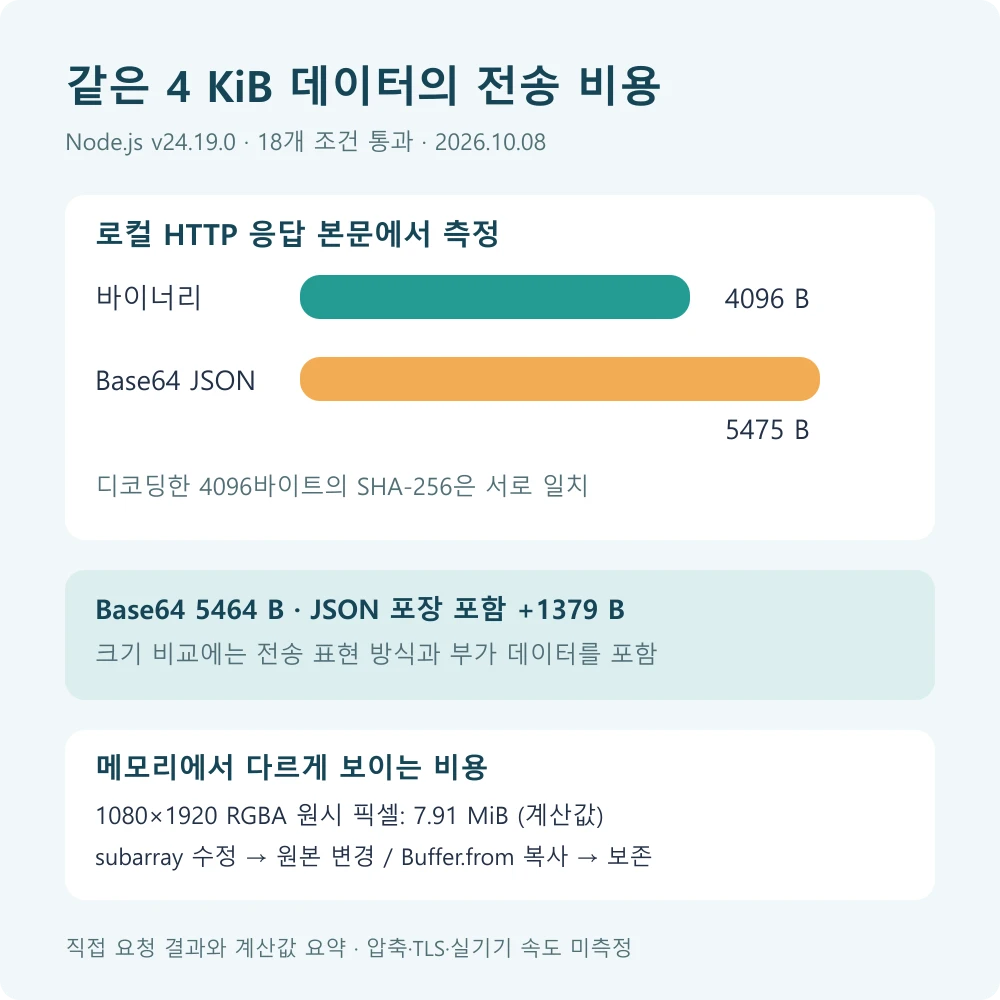
같은 데이터가 4096·5464·5475바이트로 달라졌다
입력은 0~255를 반복한 결정적 바이트 4,096개였습니다. 바이너리는 그대로 전송했고 JSON은 {"data":"Base64 문자열"}로 포장했습니다. 두 요청 모두 HTTP 200이었고 Content-Length와 실제 수신 길이가 일치했습니다.
| 표현 | 크기 | 원본 대비 비용 | 직접 확인한 것 |
|---|---|---|---|
| 원시 바이너리 | 4096 B | 기준 | 수신 4096 B |
| Base64 문자열 | 5464 B | +1368 B | 4×ceil(4096/3) |
| Base64 JSON | 5475 B | +1379 B | 수신 5475 B |
| 16진 문자열 | 8192 B | 2배 | 한 바이트당 두 문자 |
Base64 JSON에서 읽은 문자열을 다시 디코딩하면 4,096바이트가 됐습니다. SHA-256은 바이너리 응답과 동일했습니다. 내용이 같다는 사실과 전송 비용이 같다는 사실은 별개입니다. 4 KiB 제한을 원본에만 적용한다면 5,475바이트 JSON 요청이 서버 제한을 넘는 이유를 놓칠 수 있습니다.
const payload = Buffer.alloc(4096);
for (let i = 0; i < payload.length; i++) payload[i] = i % 256;
const base64 = payload.toString('base64');
const json = Buffer.from(JSON.stringify({ data: base64 }));
console.log(payload.length, base64.length, json.length);
// 4096 5464 5475
문자열 length는 업로드 바이트 제한이 아니다
앱😀은 JavaScript length로 3, UTF-8로 7바이트였습니다. 앱 글자는 UTF-8 3바이트, 이모지는 4바이트이고 이모지는 UTF-16에서 두 코드 단위를 사용합니다. ASCII만 넣은 테스트에서는 length와 바이트가 우연히 같아 이 문제를 숨길 수 있습니다.
const value = '앱😀';
console.log(value.length);                   // 3
console.log(Buffer.byteLength(value, 'utf8')); // 7
메모리·파일·HTTP 제한을 검사할 때는 실제 인코딩 뒤의 바이트 수를 사용합니다. 사용자가 보는 글자 수 제한은 그래핌 기준 요구사항을 따로 정합니다. 한글이 깨지는 디코더 진단은 HTTP charset와 Unicode 왕복 실험에서 다룹니다.
파일 압축 크기와 원시 픽셀 크기를 구분
1080×1920, 픽셀당 RGBA 4바이트라는 가정의 원시 데이터는 1080 × 1920 × 4 = 8,294,400 B, 약 7.91 MiB입니다. 이 값은 산술 계산 결과이며 실제 이미지를 디코딩해서 프로세스 메모리를 측정한 수치는 아닙니다.
디스크의 JPEG나 WebP 크기는 압축된 파일 길이입니다. 앱에서 디코딩하면 픽셀 버퍼가 필요하고, 리사이즈·GPU 업로드·캐시로 사본이 더 생길 수 있습니다. 따라서 파일이 작다는 이유만으로 목록 화면의 메모리 사용도 작다고 결론내리지 않습니다. 채널 수, stride, 색상 형식, 플랫폼 버퍼가 달라지면 위 계산도 달라집니다.
바이트 뷰는 복사본이 아니다
const source = Buffer.from([10, 20, 30, 40]);
const view = source.subarray(1, 3);
const copy = Buffer.from(view);
view[0] = 99;
console.log([...source]); // [10, 99, 30, 40]
console.log([...copy]);   // [20, 30]
실행에서 view 수정은 원본을 바꿨고 copy는 20·30을 유지했습니다. 뷰는 복사 비용을 줄이지만 원본과 수정을 공유합니다. 큰 버퍼 일부를 오래 보관할 때는 원본 backing store가 함께 유지될 수 있다는 점도 고려합니다. 이 실험은 공유 여부를 확인했으며 GC 회수량은 측정하지 않았습니다.
뷰의 backing ArrayBuffer를 API에 넘길 때는 byteOffset과 byteLength도 함께 넘겨야 의도한 구간을 지정할 수 있습니다. 전체 view.buffer만 전달하면 뷰 바깥의 데이터까지 범위에 포함될 수 있습니다. 테스트의 올바른 범위는 두 바이트 99·30이었습니다.
크기 문제를 발견하면 이 네 숫자를 기록
| 기록할 값 | 확인할 질문 |
|---|---|
| 원본 바이트 수 | 압축 파일인지 디코딩 데이터인가? |
| 직렬화된 본문 바이트 수 | Base64·JSON·필드 이름 비용을 포함했는가? |
| 실제 수신 바이트 수 | 선언된 길이와 일치하는가? |
| 복원한 데이터와 해시 | 내용이 유지됐는가? |
기록에는 데이터 본문을 모두 넣을 필요가 없습니다. 길이, 표현 방식, 개인정보 없는 테스트 해시만으로도 “크기 초과”와 “내용 손상”을 나눌 수 있습니다. 해시가 일치해도 인증이나 안전한 출처를 보장하는 것은 아닙니다.
이번 결과를 재현하는 조건
node byte_budget_test.mjs
// Node.js v24.19.0, checks: 18, passed: true
// /binary received=4096, /json received=5475
gzip·Brotli, TLS, multipart 경계, 실제 모바일 네트워크는 포함하지 않았습니다. 위 차이는 압축 없는 응답 본문 기준입니다. 업로드 방식을 결정할 때는 서버가 실제로 적용하는 제한 계층과 형식을 확인해야 합니다.
필드별 비트 폭과 패킹은 16비트 헤더 전수 검증으로 이어집니다. 크기와 메모리 API의 공식 근거는 실행 버전과 같은 Node.js 24.19.0 Buffer 문서이며, byteLength·Base64·subarray·ArrayBuffer 범위를 2026년 10월 8일 직접 대조했습니다.