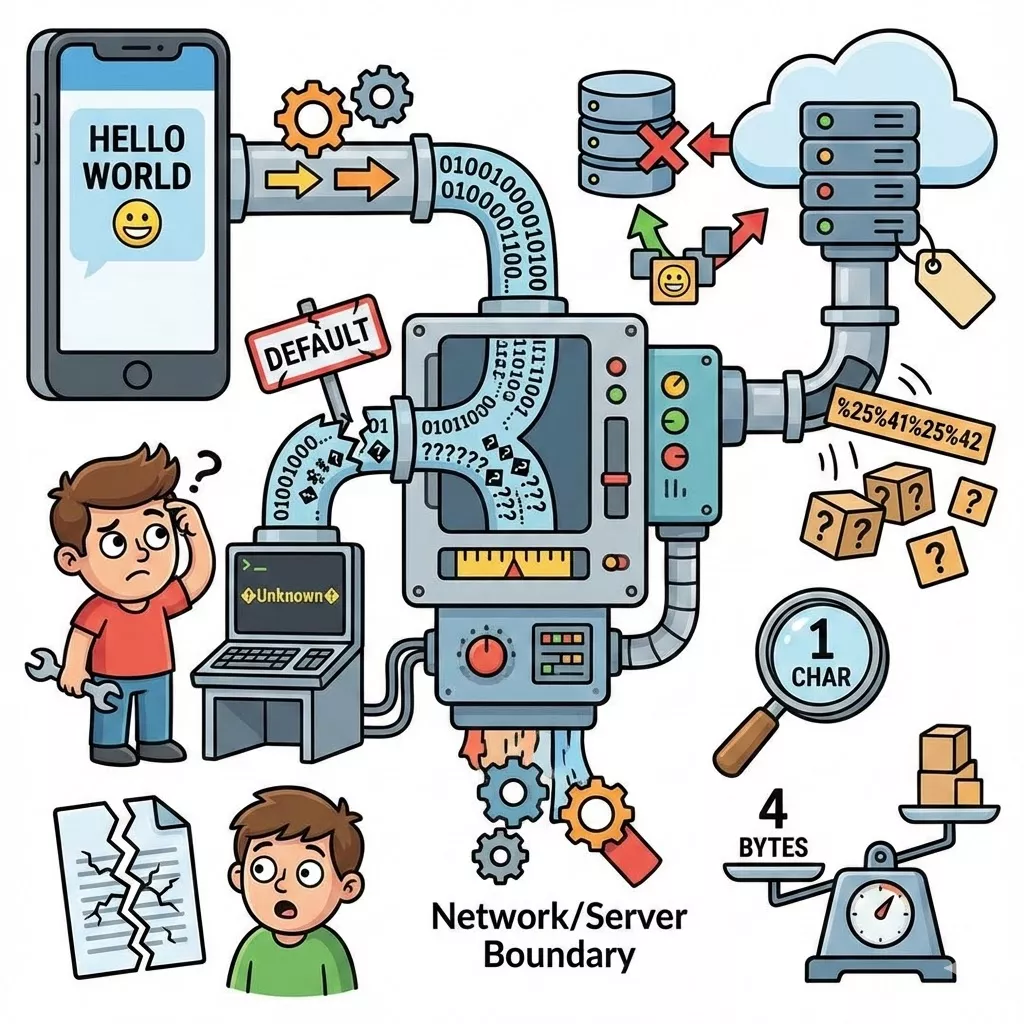
한글 깨짐은 화면 글꼴보다 “어느 단계에서 바이트를 어떤 문자셋으로 문자열로 바꿨는가”를 먼저 찾아야 합니다. 같은 UTF-8 바이트라도 HTTP 헤더가 ISO-8859-1이라고 하면 íê¸ 같은 문자열이 되고, 대체 문자 �로 바뀐 뒤에는 원문 복구가 어려워집니다.
2026년 10월 5일 Python 3.12.14로 127.0.0.1 격리 HTTP 서버를 만들었습니다. 올바른 UTF-8, 잘못 표시된 UTF-8, CP949, JSON 응답을 실제 요청하고 SQLite 저장 왕복과 한글 NFC/NFD를 포함한 11개 조건을 검증했습니다.
진단은 화면 문자열이 아니라 원시 바이트에서 시작한다
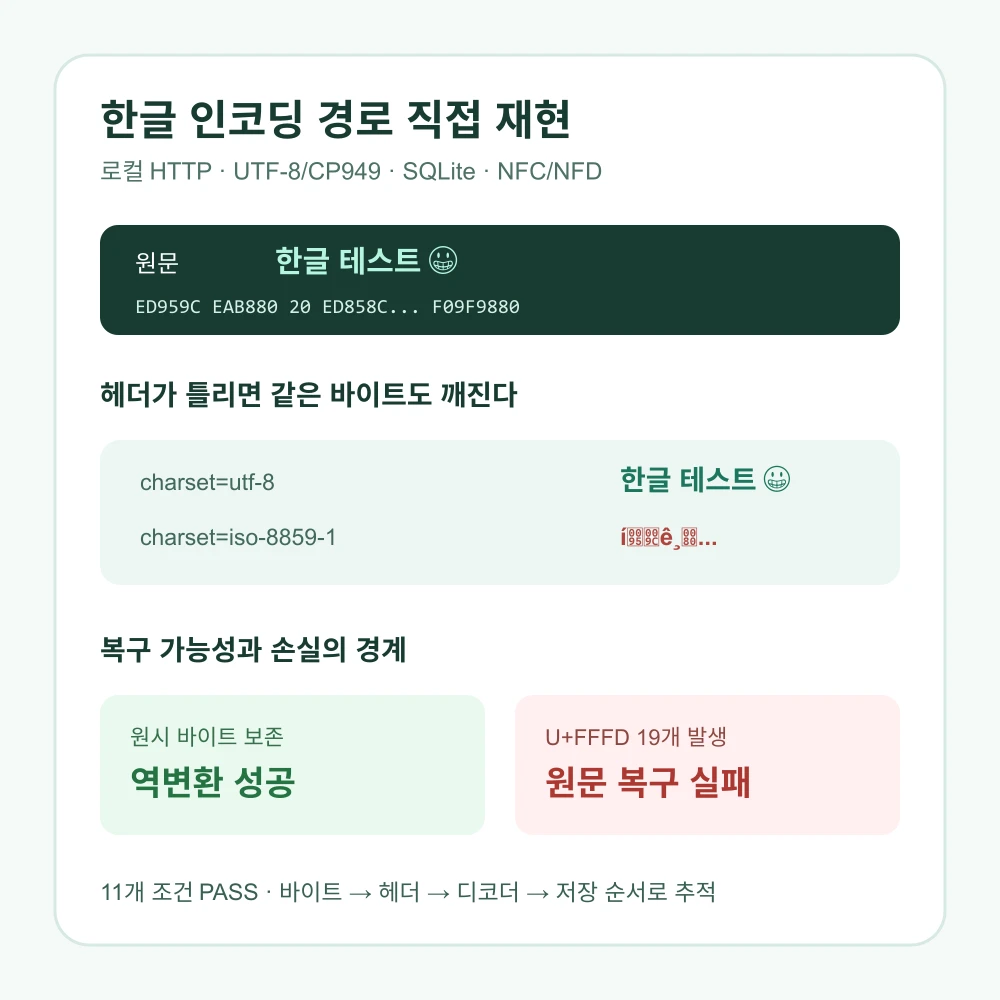
원문 한글 테스트 😀의 UTF-8 16진수는 ed959c eab880 20 ed858c ec8aa4 ed8ab8 20 f09f9880였습니다. 올바른 응답은 Content-Type: text/plain; charset=utf-8을 보내고 그대로 원문으로 디코딩됐습니다.
깨진 문자열만 캡처하면 서버가 잘못 보냈는지 클라이언트가 잘못 읽었는지 구분하기 어렵습니다. 개발 로그에는 민감정보를 제외한 원시 바이트 앞부분, Content-Type, 선택된 디코더, 디코딩 오류 발생 여부를 함께 남깁니다.
바이트는 같은데 charset 헤더만 틀린 경우
| 응답 | 실제 바이트 | 선언 charset | 결과 |
|---|---|---|---|
| /utf8 | UTF-8 | utf-8 | 한글 테스트 😀 |
| /wrong-header | UTF-8 | iso-8859-1 | í긅 |
| /cp949 | CP949 | euc-kr | 한글 테스트 |
| /json | UTF-8 JSON | utf-8 | message 원문 일치 |
잘못된 헤더 사례는 원시 UTF-8 바이트가 보존되어 있었기 때문에 Latin-1 문자열을 다시 바이트로 바꾸고 UTF-8로 디코딩해 원문을 복구할 수 있었습니다. 이것은 응급 복구 가능성을 보여 주는 실험이지, 운영 코드에서 이중 변환을 권장하는 방법은 아닙니다. 송신자가 정확한 Content-Type을 보내는 것이 해결책입니다.
U+FFFD가 들어오면 복구 가능성을 먼저 판단한다
UTF-8 바이트를 ASCII로 오류 대체 디코딩하자 U+FFFD가 19개 생겼습니다. 대체 문자는 “여기에 해석하지 못한 바이트가 있었다”는 표시일 뿐 원래 바이트 값을 담지 않습니다. 다시 인코딩하고 UTF-8로 읽어도 원문과 같아지지 않았습니다.
| 관찰 상태 | 복구 가능성 | 해야 할 일 |
|---|---|---|
| 원시 바이트 보존 | 다른 charset으로 재시도 가능 | 정확한 원본 인코딩 확인 |
| Latin-1로 1:1 잘못 해석 | 조건부 역변환 가능 | 샘플로 검증 후 일괄 처리 |
| U+FFFD 포함 문자열만 존재 | 원 바이트 정보 손실 | 백업·원본 시스템에서 복원 |
| 물음표로 DB 저장 | 대개 손실 | 원본 재수집과 컬럼 설정 수정 |
DB 왕복이 성공해도 검색은 정규화 때문에 어긋날 수 있다
메모리 SQLite에 원문, NFC 한글 가(U+AC00), NFD 한글 가(U+1100 U+1161)를 저장하고 다시 읽었습니다. 세 문자열은 정확히 왕복했지만 NFC와 NFD는 원시 비교에서 달랐습니다. NFD를 NFC로 정규화한 뒤에만 같아졌습니다.
즉 DB가 문자를 보존했다는 사실과 검색 키가 동일하다는 사실은 다릅니다. 사용자명·태그·파일명처럼 동등 문자열 비교가 필요한 경계에서는 한 가지 정규화 정책을 정하고 입력과 검색어에 같은 정책을 적용합니다. 표시용 원문을 별도로 보존해야 하는 요구사항도 함께 검토합니다.
문자 수·바이트 수·UTF-16 단위는 서로 다르다
한글😀은 Python 코드 포인트 기준 3개, UTF-8 10바이트, UTF-16 코드 단위 4개였습니다. 이모지는 UTF-16에서 서로게이트 두 단위를 사용하기 때문입니다.
| 제한 대상 | 써야 할 측정 | 예 |
|---|---|---|
| DB/패킷 저장 공간 | 인코딩된 바이트 | UTF-8 10바이트 |
| Unicode 처리 | 코드 포인트 또는 그래핌 | 요구사항에 맞춰 선택 |
| JavaScript/Dart 일부 API | UTF-16 코드 단위 여부 확인 | 이모지 2단위 |
| 화면 글자 제한 | 사용자가 보는 grapheme cluster | 결합 문자 고려 |
length 하나를 모든 제한에 사용하지 않습니다. 업로드 바이트 제한과 화면 문자 제한은 서로 다른 검사입니다.
깨진 위치를 찾는 네 단계
- 송신 전: 서버/DB에서 원문과 Unicode 코드 포인트를 확인합니다.
- 전송: 실제 응답 바이트와 Content-Type charset을 저장합니다.
- 수신 직후: 프레임워크가 선택한 디코더와 U+FFFD 포함 여부를 봅니다.
- 저장 후: 다시 읽은 문자열의 바이트·정규화 형태를 원본과 비교합니다.
첫 번째로 달라지는 경계를 고치면 됩니다. 이미 깨진 문자열에 UTF-8 변환을 반복 적용하면 원인과 손실을 더 키울 수 있습니다.
DB 설정을 바꿀 때 확인할 범위
MySQL을 사용한다면 서버 기본값 하나만 보지 말고 데이터베이스·테이블·컬럼 문자셋과 연결 세션을 함께 확인합니다. MySQL 공식 문서는 utf8 계열 중 utf8mb4 사용을 안내합니다. 기존 컬럼 변경 전에는 실제 데이터 백업과 변환 결과 샘플 검증이 필요합니다.
이번 실험은 SQLite 문자열 왕복만 수행했으므로 MySQL 마이그레이션 성공을 주장하지 않습니다. DB 제품별 collation, 인덱스 길이, 연결 드라이버 설정은 별도 검증 대상입니다.
실험 범위
- 로컬 HTTP 서버만 사용했고 실제 CDN·프록시·모바일 WebView는 연결하지 않았습니다.
- CP949 예제에는 이모지를 넣지 않았습니다. 해당 문자셋으로 표현할 수 없기 때문입니다.
- SQLite 왕복은 저장 보존만 확인했으며 MySQL·PostgreSQL 설정을 실행하지 않았습니다.
- 글꼴에 글리프가 없는 표시 문제는 인코딩 깨짐과 별개이며 이 실험에서 다루지 않았습니다.