바이트에는 음수라는 표지가 붙어 있지 않습니다. 0xFF를 255로 읽을지 -1로 읽을지는 그 바이트를 만든 프로토콜의 폭과 부호 계약이 결정합니다. 그래서 로그에 음수가 보인다고 데이터를 고치는 것보다, 먼저 원시 바이트와 계약을 대조해야 합니다.
2026년 10월 4일 Node.js 24.19.0의 Buffer로 8비트 256개와 16비트 65,536개 값을 전부 생성했습니다. 내장 signed 읽기 결과가 2의 보수 변환식과 같은지 확인했고, 엔디안·32비트 카운터·체크섬 사례를 더해 총 65,800개 조건을 통과했습니다.
0x80부터 값의 해석이 갈린다
| 원시 바이트 | UInt8 | Int8 | 판단 |
|---|---|---|---|
00 |
0 | 0 | 같음 |
7F |
127 | 127 | signed 최댓값 |
80 |
128 | -128 | 부호 경계 |
FF |
255 | -1 | 모든 비트가 1 |
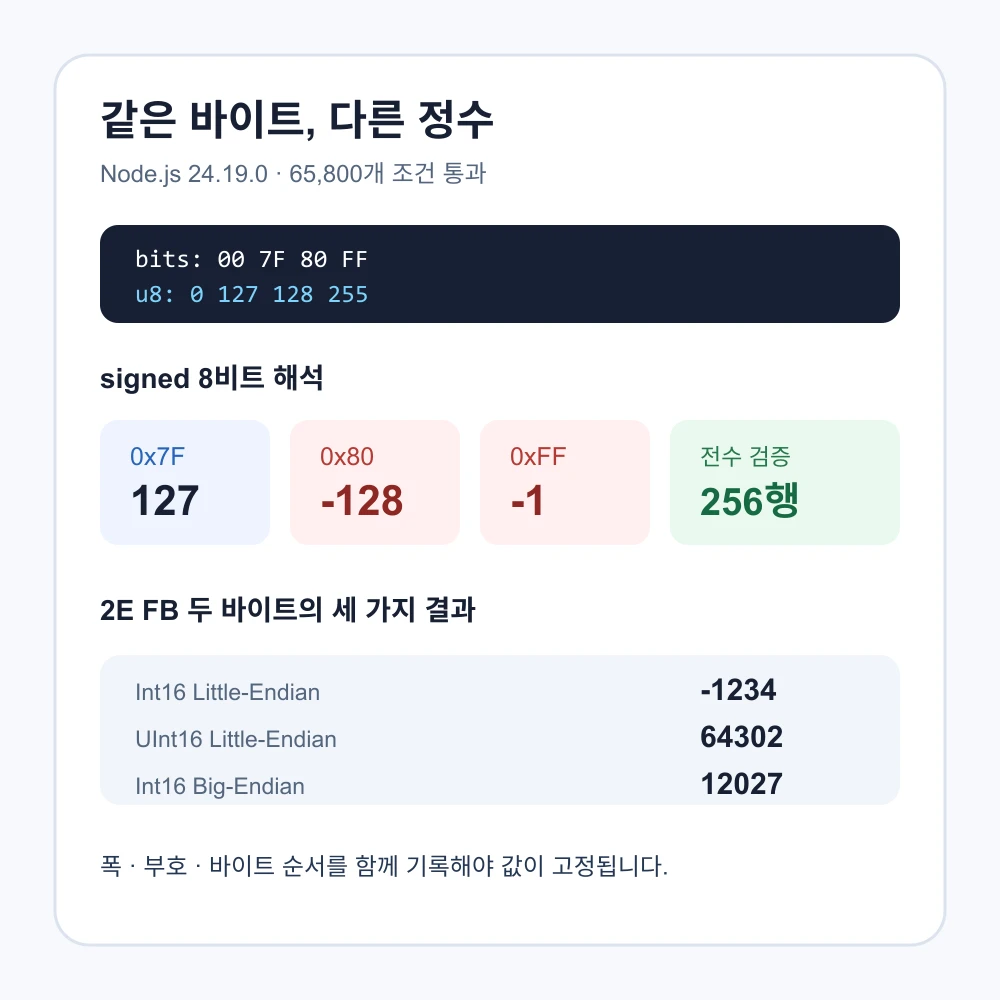
n비트 unsigned 값 u의 최상위 비트가 1이면 signed 값은 u - 2^n입니다. 이 식과 Buffer.readInt8() 결과를 0부터 255까지 비교했고 모두 일치했습니다. 같은 방식으로 UInt16 0부터 65,535까지를 little-endian 바이트로 쓴 뒤 Int16으로 읽어 65,536행을 확인했습니다.
2E FB가 -1234, 64302, 12027이 되는 이유
두 바이트 2E FB를 세 계약으로 읽은 결과입니다.
| 폭·부호·순서 | 결과 | 틀렸을 때 보이는 증상 |
|---|---|---|
| Int16 Little-Endian | -1234 | 의도한 센서 원시값 |
| UInt16 Little-Endian | 64302 | 음수 센서가 큰 양수로 보임 |
| Int16 Big-Endian | 12027 | 부호뿐 아니라 크기도 달라짐 |
“음수가 이상하다”는 이유로 절댓값을 취하거나 65,536을 임의로 더하는 처리는 원인을 숨깁니다. 스펙이 Int16 LE라면 읽는 순간 그 계약을 코드에 고정하고, 그 다음에만 스케일을 적용해야 합니다.
상위 비트가 켜진 카운터는 감소한 것이 아니다
00 00 00 80을 UInt32 LE로 읽으면 2,147,483,648이고 Int32 LE로 읽으면 -2,147,483,648입니다. 서버가 unsigned 누적 카운터를 보냈는데 앱이 signed 32비트로 받으면 경계에서 갑자기 음수로 전환됩니다. 이 경우 카운터 감소 로직을 의심하기 전에 필드 계약을 확인해야 합니다.
const bytes = Buffer.from([0x00, 0x00, 0x00, 0x80]);
bytes.readUInt32LE(0); // 2147483648
bytes.readInt32LE(0);  // -2147483648
체크섬은 숫자 의미가 아니라 원시 바이트로 계산한다
FF 80 7F 01의 각 바이트 합을 256으로 나눈 체크섬은 255였습니다. 같은 바이트를 먼저 Int8로 읽으면 -1, -128, 127, 1이 되지만, 각 값을 다시 & 0xFF로 정규화한 뒤 합치면 역시 255가 됐습니다.
체크섬·CRC·암호 입력은 온도나 카운터처럼 해석된 숫자가 아니라 전송된 바이트열을 대상으로 합니다. signed 배열을 거쳤다면 각 원소를 원래 8비트로 되돌렸는지 확인합니다.
로그에는 값 하나보다 해석 계약을 남긴다
field=temperature raw=2efb width=16 signed=true endian=little rawValue=-1234 scale=0.01 value=-12.34이 한 줄이면 원본, 폭, 부호, 바이트 순서, 스케일 적용 전후를 함께 대조할 수 있습니다. 반대로 temperature=-12.34만 남기면 어느 단계에서 값이 틀렸는지 재현하기 어렵습니다.
| 증상 | 먼저 비교할 원시값 | 가능성이 큰 오류 |
|---|---|---|
| 128부터 음수가 됨 | 7F / 80 |
UInt8을 Int8로 읽음 |
| 32768부터 음수가 됨 | FF 7F / 00 80 |
UInt16을 Int16으로 읽음 |
| 음수가 큰 양수로 보임 | 2E FB |
Int16을 UInt16으로 읽음 |
| 값의 크기까지 크게 달라짐 | 두 바이트 순서 | 엔디안 불일치 |
프로토콜 필드마다 네 가지 질문에 답한다
“정수”라는 타입 이름만으로는 바이트를 재현할 수 없습니다. 필드 정의에 폭, 부호, 엔디안, 단위를 함께 적어야 합니다. 예를 들어 temperature: Int16 LE, 0.01°C와 sequence: UInt32 LE, wrap allowed는 같은 정수라도 테스트 방법이 다릅니다.
- 폭: 8·16·32비트 중 몇 바이트를 소비하는가?
- 부호: 최상위 비트를 부호로 쓰는가, 값으로 쓰는가?
- 순서: 여러 바이트의 최하위 바이트가 먼저 오는가?
- 단위: 원시 정수에 어떤 스케일과 오프셋을 적용하는가?
테스트 벡터도 필드마다 최소 세 종류를 둡니다. 0 또는 정상값 하나, 부호가 갈리는 최상위 비트 경계, 모든 비트가 1인 최댓값입니다. 엔디안이 있는 필드는 서로 다른 두 바이트를 골라 순서를 뒤집었을 때 같은 값이 되지 않게 해야 합니다. 00 00처럼 대칭인 값만 쓰면 엔디안 오류를 검출하지 못합니다.
쓰기와 읽기를 같은 구현만으로 확인하지 않는다
한 라이브러리로 값을 쓰고 같은 라이브러리로 다시 읽는 왕복 테스트는 내부적으로 같은 잘못을 공유할 수 있습니다. 이번 전수 검사는 Buffer 읽기 결과를 별도의 수식 u >= 2^(n-1) ? u - 2^n : u와 비교했습니다. 실제 프로젝트에서도 스펙 문서의 고정 바이트 예시, 다른 언어의 참조 구현 또는 기기 제조사가 제공한 골든 벡터 중 하나를 독립 기준으로 두는 편이 좋습니다.
이 실행이 확인한 범위
- Node.js Buffer의 8·16·32비트 정수 읽기와 순수 2의 보수 변환을 Windows x64에서 확인했습니다.
- BLE 기기나 실제 센서에는 연결하지 않았고 특정 제조사의 프로토콜을 가정하지 않습니다.
- 부동소수점, 64비트 BigInt, CRC 다항식의 정확성은 이 실험 범위가 아닙니다.
- 모든 프로토콜이 little-endian이라는 뜻이 아닙니다. 필드별 명세가 최종 기준입니다.
구현 단계로 이어서 확인하기
이 글은 언어와 무관한 “바이트 계약을 먼저 고정하는 법”에 초점을 둡니다. Flutter 코드에서 실제 패킷 오프셋과 ByteData를 검증하려면 Flutter ByteData에서 음수 읽기를, 정수 범위 자체를 다시 보려면 비트로 정수를 표현하는 방법을 참고할 수 있습니다.