앱이 느릴 때 “CPU가 처리할 명령이 많아서”라고 설명하면 원인을 절반만 본 것입니다. 같은 반복 횟수와 같은 데이터라도 다음에 읽을 주소를 예측하기 쉬운지, 직전 읽기 결과를 기다려야 하는지에 따라 시간이 달라질 수 있습니다. 반대로 코드가 길어 보여도 실제 사용자 동작에서 거의 실행되지 않는다면 우선순위가 아닐 수 있습니다.
이 차이를 눈으로 확인하기 위해 4MiB 크기의 값 배열을 두 가지 순서로 읽는 작은 실험을 만들었습니다. 한쪽은 다음 원소를 연속 주소로 연결하고, 다른 쪽은 고정 seed로 섞은 하나의 포인터 cycle로 연결했습니다. 두 방식은 같은 원소를 빠짐없이 같은 횟수만큼 읽고 checksum도 일치하지만, 메모리 위치를 방문하는 순서가 다릅니다.
이번 측정이 답하려는 질문
비교하려는 것은 “JavaScript가 Flutter보다 빠른가?”가 아닙니다. 아래 두 질문만 확인합니다.
- 같은 값 배열과 반복 횟수에서도 연속 접근과 의존적 무작위 접근의 관찰 시간이 달라지는가?
- 그 결과만으로 실제 Flutter 앱의 병목을 단정해도 되는가?
첫 질문은 로컬 마이크로벤치마크로 관찰할 수 있습니다. 두 번째 질문의 답은 “아니요”입니다. 실제 Flutter 앱에는 위젯 rebuild, Dart 객체 할당, image decode, I/O, 플랫폼 채널, GPU raster처럼 이 실험에 없는 작업이 많습니다. 따라서 실험 결과는 메모리 접근을 이해하는 사례이고, 앱 최적화 대상은 실제 profile trace에서 다시 찾아야 합니다.
재현 환경과 조건
| 항목 | 이번 실행 값 | 이 값을 기록한 이유 |
|---|---|---|
| 운영체제 | Windows 10.0.19045 x64 | 스케줄러·메모리 환경이 결과에 영향을 줄 수 있음 |
| CPU | AMD Ryzen 5 5600G | cache 구조와 clock 조건이 기기마다 다름 |
| 런타임 | Node.js v24.19.0 | JIT과 TypedArray 구현 차이를 구분 |
| 데이터 | Uint32Array 1,048,576개 | 배열 하나당 4,194,304 byte |
| sample당 순회 | 8회, 8,388,608개 값 읽기 | 두 방식의 작업량 고정 |
| 측정 표본 | 각 방식 9회 | 한 번의 우연한 값 대신 중앙값 사용 |
| 무작위 순서 | 고정 seed xorshift32, 단일 cycle | 모든 원소를 한 번씩 방문하고 재현 가능하게 함 |
측정 전 두 방식을 한 번씩 예열해 최초 JIT·page fault 영향을 줄였고, 이후 sample마다 실행 순서를 번갈아 배치했습니다. 백그라운드 프로세스와 CPU 온도를 완전히 통제한 실험실 측정은 아니므로 개별 시간보다 중앙값과 표본 범위를 함께 봅니다.
실행 코드의 핵심: 두 배열 읽기와 주소 의존성을 맞추기
단순 for (i++)와 포인터 추적을 비교하면 후자만 “다음 위치 배열”을 추가로 읽게 됩니다. 이번에는 연속 조건도 sequentialNext[index]를 읽게 만들어 두 방식 모두 값 배열과 다음 위치 배열을 한 번씩 참조하도록 맞췄습니다.
const elementCount = 2 ** 20;
const repeatsPerSample = 8;

const values = new Uint32Array(elementCount);
const sequentialNext = new Uint32Array(elementCount);

for (let index = 0; index < elementCount; index += 1) {
  values[index] = (index * 17 + 3) & 0xffff;
  sequentialNext[index] = index + 1 === elementCount ? 0 : index + 1;
}

function dependentSequentialRead() {
  let checksum = 0;
  let index = 0;
  for (let repeat = 0; repeat < repeatsPerSample; repeat += 1) {
    for (let visited = 0; visited < values.length; visited += 1) {
      checksum = (checksum + values[index]) >>> 0;
      index = sequentialNext[index];
    }
  }
  return checksum;
}

function dependentRandomRead() {
  let checksum = 0;
  let index = shuffledCycleStart;
  for (let repeat = 0; repeat < repeatsPerSample; repeat += 1) {
    for (let visited = 0; visited < values.length; visited += 1) {
      checksum = (checksum + values[index]) >>> 0;
      index = shuffledNext[index];
    }
  }
  return checksum;
}shuffledNext는 0부터 1,048,575까지의 순서를 Fisher–Yates 방식으로 섞은 뒤 마지막 원소를 첫 원소에 연결해 만들었습니다. 따라서 중간에 같은 작은 구간만 반복하거나 방문하지 않는 원소가 생기지 않습니다. 두 함수의 checksum이 다르면 측정을 중단하도록 했습니다.
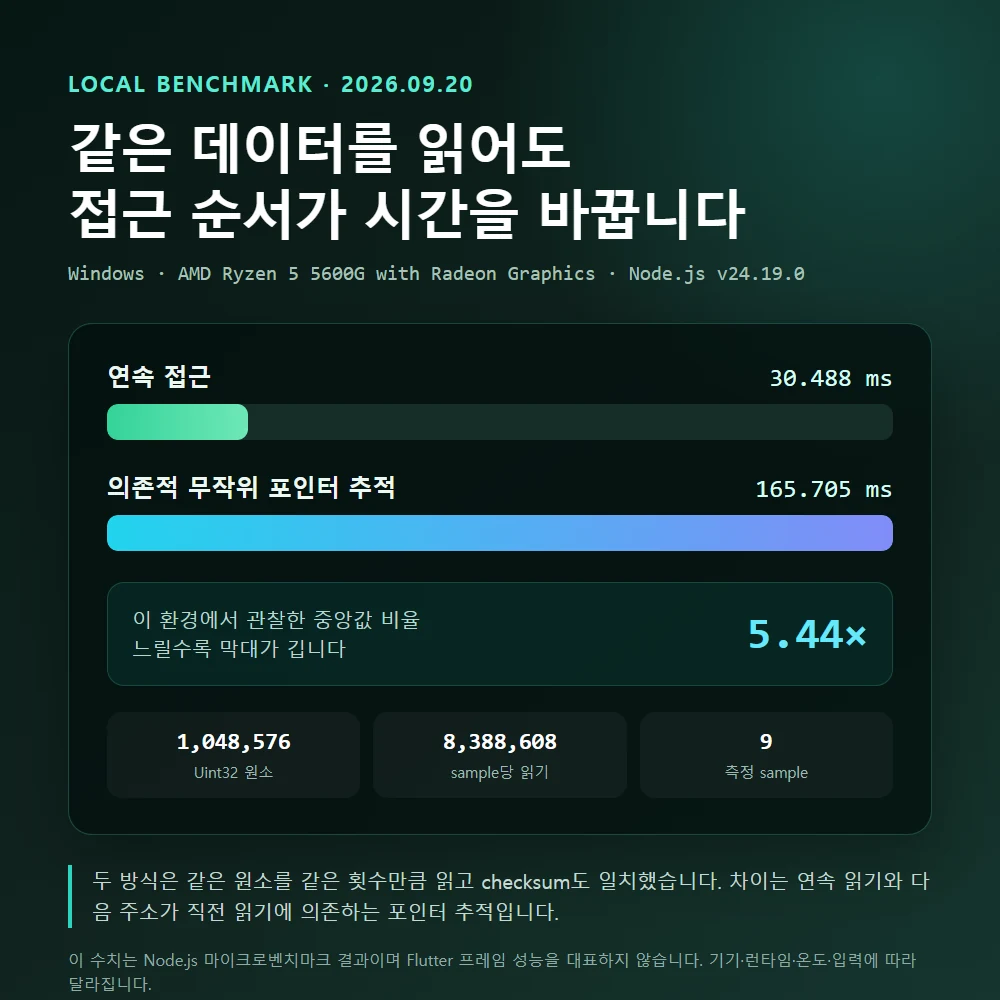
관찰 결과: 중앙값 30.488ms와 165.705ms
PowerShell에서 node evidence2026-09-20-memory-access-benchmark.mjs를 실행한 결과입니다.
연속 접근 표본(ms)
30.398, 32.538, 30.651, 30.469, 30.488,
30.672, 30.360, 30.372, 30.672

의존적 무작위 포인터 추적 표본(ms)
165.705, 152.737, 163.411, 179.751, 188.250,
258.124, 319.079, 133.165, 155.825

중앙값
연속 접근: 30.488ms
무작위 포인터 추적: 165.705ms
관찰 비율: 5.44배
checksum 일치: true
무작위 표본은 133.165~319.079ms로 변동 폭이 컸습니다. 그래서 가장 빠르거나 가장 느린 한 번을 대표값으로 쓰지 않고 중앙값을 사용했습니다. 이 환경에서는 무작위 포인터 추적 중앙값이 5.44배 길었지만, 이 숫자를 다른 PC·Android 기기·Dart VM에 그대로 적용할 수는 없습니다.
왜 접근 순서가 달라지면 시간이 달라지는가?
CPU는 필요한 값을 매번 같은 비용으로 가져오지 않습니다. 연속된 주소를 읽으면 인접 데이터가 cache line에 함께 들어오고 다음 접근도 예측하기 쉬워질 수 있습니다. 반면 이 실험의 무작위 포인터 추적은 next[index]를 읽어야 다음 index를 알 수 있습니다. 다음 주소 계산이 직전 load에 의존하므로 여러 load를 미리 병렬로 진행하기 어렵고, 방문 위치도 넓게 흩어집니다.
따라서 “두 loop 모두 8,388,608번이니 속도가 같아야 한다”는 추론은 성립하지 않습니다. 반복 횟수나 소스 코드 줄 수는 일부 정보일 뿐, 데이터 배치와 접근 의존성까지 봐야 합니다. 그렇다고 모든 무작위 접근을 연속 배열로 바꿔야 한다는 뜻도 아닙니다. Map·그래프·트리처럼 문제 자체가 임의 접근을 요구할 수 있고, 데이터가 작으면 cache 안에서 차이가 작을 수 있습니다.
앱 코드에서 이 패턴이 나타나는 위치
| 앱 코드 형태 | 관찰할 문제 | 먼저 확인할 대안 |
|---|---|---|
| 한 화면에서 여러 Map과 객체를 따라가며 목록 생성 | 변환 함수 self time, 짧은 객체 allocation | 화면용 연속 모델을 데이터 변경 시 한 번 생성 |
| build마다 filter·sort·groupBy 반복 | 같은 입력에 같은 계산 반복 | 입력·조건 변경 시점으로 계산 이동 |
| 화면 밖 항목까지 모두 widget 생성 | 긴 build와 메모리 증가 | builder 기반 지연 생성과 pagination |
| 큰 JSON을 메인 isolate에서 변환 | UI thread의 긴 CPU 구간 | 먼저 payload·파싱 시간을 측정하고 필요할 때 isolate 검토 |
| 이미지 원본을 화면 크기보다 크게 decode | raster·memory·GC 부담 | 표시 크기에 맞는 asset·decode 설정 |
| 리스너 해제 누락으로 화면 객체 유지 | 반복 진입 후 heap 기준선 상승 | retaining path와 dispose 경로 확인 |
목록 정렬은 메모리 배치와 함께 comparator 호출, 동률 규칙, 원본 복사 비용도 포함합니다. 앱 목록 정렬 구현 점검에서 comparator와 서버 pagination의 동률 기준을 따로 다룹니다.
Flutter에서는 숫자를 다시 측정해야 한다
Flutter 공식 문서는 UI 성능 분석을 실제 Android·iOS 기기의 profile mode에서 수행하도록 안내합니다. debug mode에는 assert와 JIT 등 개발 편의를 위한 비용이 들어가며, emulator와 simulator는 실제 기기와 하드웨어 조건이 다릅니다. 이번 Node 결과를 Flutter 예상치로 옮기는 대신 다음 순서로 병목을 찾습니다.
- 느림을 재현할 사용자 동작, 데이터 개수, 시작 상태를 고정합니다.
- 지원하는 기기 중 성능이 낮은 실제 기기에서
flutter run --profile로 실행합니다. - Performance view에서 느린 frame이 UI 작업인지 raster 작업인지 먼저 나눕니다.
- CPU Profiler의 Bottom up에서 self time이 큰 method를 찾고 Call tree에서 호출 경로를 확인합니다.
- Memory view에서 allocation 증가가 일시적 churn인지 반복 동작 뒤에도 기준선이 올라가는 retention인지 구분합니다.
- 한 가지 변경만 적용하고 같은 trace 구간·입력으로 다시 측정합니다.
Flutter CPU Profiler는 Dart VM이 수집한 call stack sample을 집계합니다. 표본 수가 많은 함수가 반드시 제거 대상은 아니므로 self time, total time, 호출 빈도와 사용자가 느낀 지연 구간을 함께 봅니다. 샘플링 주기를 높이면 더 세밀해지지만 앱을 더 자주 중단하고 sample buffer도 빨리 채운다는 trade-off가 있습니다.
프레임 예산과 CPU 작업을 연결하는 법
60Hz 화면에서는 새 frame을 약 16ms마다 표시해야 합니다. 그러나 “어떤 함수가 16ms보다 짧으니 안전하다”라고 단순 판정하면 안 됩니다. 한 frame에는 해당 함수 외에도 build, layout, paint와 다른 callback이 함께 들어갑니다. 120Hz 기기에서는 표시 간격도 더 짧습니다.
Flutter Performance view에서 UI thread가 긴지, raster thread가 긴지 먼저 봅니다. UI 쪽이 길고 CPU profile에서 같은 데이터 변환이 상위에 있다면 계산 시점·데이터 구조를 바꿀 근거가 생깁니다. raster 쪽이 긴데 목록 데이터 구조만 바꾸면 문제 층이 달라 효과가 없을 수 있습니다.
화면 종료 뒤 callback이 계속 실행되거나 controller가 유지되는 문제는 setState() called after dispose의 취소·lifecycle 점검처럼 별도의 생명주기 증거가 필요합니다.
Memory 그래프에서 상승과 누수를 구분하기
메모리가 올라갔다는 사실만으로 leak이라고 부르지 않습니다. 객체 생성 뒤 garbage collection이 아직 실행되지 않았거나 image cache가 재사용을 위해 데이터를 보관할 수도 있습니다. 다음과 같이 반복 가능한 시나리오로 기준선을 비교합니다.
- 앱 시작 뒤 안정된 시점의 heap과 화면 상태를 기록합니다.
- 의심 화면 진입·스크롤·종료를 같은 횟수만큼 반복합니다.
- DevTools에서 allocation class와 retaining path를 확인합니다.
- GC 뒤에도 같은 화면 객체·listener·controller가 남는지 봅니다.
- 수정 뒤 같은 기기·빌드·입력에서 기준선과 churn을 다시 비교합니다.
Android Studio에서 allocation 기록이나 heap dump가 필요하면 debuggable app이 필요할 수 있고, 낮은 overhead의 일반 CPU·memory profiling은 release variant 기반의 profileable app으로 수행할 수 있습니다. 측정 도구 자체의 overhead와 가능한 기능이 다르므로 결과에 build 종류를 함께 남깁니다.
최적화를 시작할지 결정하는 표
| 측정 결과 | 판단 | 다음 행동 |
|---|---|---|
| 느린 frame과 특정 변환 함수의 높은 self time이 같은 구간에 있음 | CPU 쪽 후보가 구체적임 | 데이터 배치·계산 시점 변경 후 재측정 |
| CPU는 짧고 raster thread만 김 | 이 글의 메모리 접근 사례와 다른 층 | saveLayer, clip, image, shader·paint 조사 |
| 객체 수가 잠깐 늘고 GC 후 기준선으로 돌아옴 | allocation churn 후보 | frame 영향과 GC 빈도를 확인 |
| 화면을 닫을 때마다 동일 객체가 누적됨 | retention 후보 | retaining path, listener와 controller 해제 확인 |
| 마이크로벤치마크만 빠르고 실제 frame은 동일 | 사용자 병목을 고치지 못함 | 변경을 유지할 복잡성 이득이 있는지 재검토 |
| 낮은 사양 실제 기기에서도 충분히 예산 안 | 지금 최적화 우선순위가 낮음 | 회귀 기준만 기록하고 기능 작업으로 복귀 |
이 벤치마크가 증명하지 않는 것
- Node.js와 Dart AOT가 같은 시간을 낸다는 뜻이 아닙니다.
- 5.44배라는 비율이 다른 CPU·데이터 크기·온도에서도 유지된다는 뜻이 아닙니다.
- 일반적인 모든 random access가 느리다는 증명이 아닙니다. 이번 코드는 다음 주소가 직전 읽기에 의존하도록 만든 포인터 추적입니다.
- Flutter UI jank의 원인이 메모리 접근이라고 판정한 것이 아닙니다. 실제 frame trace가 필요합니다.
- GC·GPU·I/O·네트워크·battery 비용을 측정하지 않았습니다.
이 한계를 적는 이유는 benchmark 숫자가 크다는 사실보다 같은 작업을 같은 조건으로 다시 실행하고, 실제 제품 trace와 연결할 수 있는가가 더 중요하기 때문입니다. 앱 출시 직전의 측정 기준과 실패 주입은 상태·동시성·오류 흐름 재현 테스트와 함께 적용할 수 있습니다.
이번 글에서 확인한 공식 자료
- Flutter: Performance profiling
- Flutter DevTools: Performance view
- Flutter DevTools: CPU Profiler
- Flutter DevTools: Memory view
- Android Developers: Profile your app performance
메모리 page 크기와 native library 정렬 문제는 일반적인 목록 접근 최적화와 다른 주제입니다. 16KB 환경에서만 설치·실행이 실패한다면 APK·ELF 정렬과 16KB 페이지 호환성 점검으로 분리해 확인합니다.